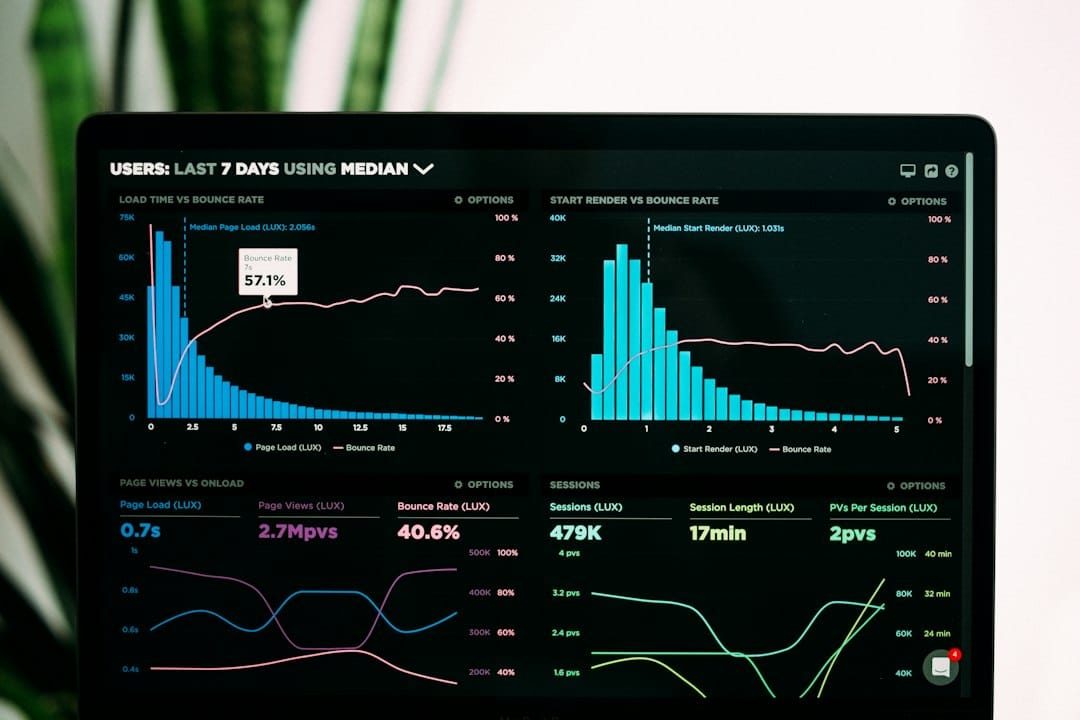
Une baie réseau peut fonctionner sans incident pendant des mois, puis subir une panne qui affecte simultanément les chambres d’un hôtel, la téléphonie et les équipements techniques. La supervision réseau doit permettre de distinguer rapidement une panne, une dégradation de performance et une fausse alerte. Il ne s’agit pas d’afficher le plus grand nombre de courbes, mais de surveiller les indicateurs qui facilitent une décision, de définir des objectifs de service et de prévoir les personnes chargées d’agir.
Pour des décideurs au Maroc, l’enjeu est souvent double : maintenir l’expérience utilisateur (clients, collaborateurs, sites distants) tout en restant réaliste sur les contraintes d’exploitation (compétences disponibles, astreinte, multi-sites, dépendance opérateur). Les sections ci-dessous proposent une approche orientée services, applicable à un hôtel comme à une entreprise multi-sites.
Photo by Luke Chesser on Unsplash
Synthèse pour décideur (en 60 secondes)
- Commencez par les services (Internet, Wi‑Fi, téléphonie IP, CCTV, applications) : la supervision doit prioriser l’impact métier.
- Séparez disponibilité et qualité : un ping OK ne garantit ni performance ni accessibilité applicative.
- Surveillez d’abord les points de concentration du risque : WAN/Internet, pare-feu/routeur, cœur réseau, uplinks d’étage, Wi‑Fi par zones, DNS/DHCP/AAA (si dans le périmètre).
- Rendez les alertes actionnables : une alerte = un service, une gravité, une durée, un responsable, une première vérification autorisée.
- Recettez la supervision (simulations contrôlées) : sans test de bout en bout, l’outil peut rassurer à tort.
Définir les services avant les métriques
Commencez par lister les services à protéger : arrivée Internet, accès aux applications métier, Wi-Fi du personnel, Wi-Fi des clients, téléphonie IP, vidéosurveillance, GRMS (Guest Room Management System, gestion technique de chambre) et contrôle d’accès. Pour chacun, notez le propriétaire, la criticité et la dépendance aux liens réseau. Le même switch peut héberger des applications aux conséquences très différentes.
Cette cartographie évite d’envoyer une alerte urgente pour un port inutilisé et de manquer la panne d’un uplink de baie d’étage. La conception d’un réseau IP hôtelier fournit un exemple de services qui doivent rester distingués.
Livrables utiles (à formaliser au niveau DSI/Direction) :
- Un catalogue de services (1 page par service : description, impact, horaires, contacts, dépendances).
- Une matrice de criticité (ce qui doit déclencher une astreinte, ce qui peut attendre).
- Un périmètre de supervision clair : ce qui est dans le NOC (Network Operations Center / exploitation réseau) et ce qui ne l’est pas.
Surveiller disponibilité et qualité séparément
Un ping qui répond ne démontre ni que le service utilisateur est disponible, ni que la connexion possède une qualité suffisante. Mesurez séparément : disponibilité des équipements, état des uplinks, taux d’erreur, pertes de paquets, latence et utilisation des interfaces selon leur rôle. Pour les applications sensibles à la voix ou à la vidéo, la gigue (variation de latence) et la qualité du chemin deviennent importantes.
Les seuils doivent être fondés sur les caractéristiques et l’activité normale du site. Une interface ponctuellement à 60 % n’a pas la même signification qu’un uplink durablement saturé. Il faut comparer les valeurs avec les horaires et les usages réels de l’établissement (check-in/check-out, pics de visioconférence, fin de journée back-office, etc.).
Priorités de supervision réseau en entreprise (en 8 points)
- Accès WAN/Internet : indisponibilité, pertes, latence, bascule (si secours).
- Pare-feu/routeur : charge, saturation, drops, sessions, VPN.
- Cœur/distribution : uplinks, boucles, erreurs, redondance.
- Accès (switches) : ports critiques, PoE, alimentations.
- Wi‑Fi : contrôleur (si présent), AP par zone, capacité clients, symptômes.
- Services réseau : DNS/DHCP/AAA (selon périmètre) et leurs symptômes.
- Expérience utilisateur : tests synthétiques (DNS + TLS + requête) vers les applications clés.
- Supervision elle-même : collecte, files d’alerting, notification, sauvegarde.
Intégrer alimentation, température et budget PoE
Les switches alimentent souvent points d’accès et caméras IP. Une supervision utile peut détecter une alimentation en défaut, un budget PoE (Power over Ethernet) proche de la saturation ou des ports dont l’alimentation a été refusée. La température et les alertes matérielles méritent aussi une observation lorsqu’elles sont accessibles.
La supervision est particulièrement précieuse après l’ajout de nouveaux terminaux : le nombre de ports libres ne suffit pas à connaître la réserve électrique restante. Les relevés doivent être rapprochés du plan de baie et de la documentation de câblage.
Équipements à ne pas oublier en supervision réseau entreprise
Au-delà des switches et points d’accès, certains équipements concentrent le risque. Les surveiller ne signifie pas tout monitorer partout : l’objectif est de couvrir ce qui conditionne réellement la disponibilité des services.
Pare-feu / UTM / routeur d’entreprise (si présent dans votre périmètre)
Le pare-feu est souvent un point unique de passage (Internet, VPN, inter-sites). Les indicateurs ci-dessous aident à distinguer une panne, une saturation et un incident de configuration.
- Ressources : CPU, mémoire, stockage (selon équipement) et tendance.
- Table d’états / sessions : niveau de remplissage et évolution.
- Drops / erreurs : paquets rejetés par manque de ressources, erreurs d’interface, files saturées.
- VPN : état des tunnels, stabilité, volume, échecs d’authentification (à interpréter).
- Changements de configuration : à surveiller si l’outil permet de journaliser ces événements (sinon, organiser une traçabilité côté processus).
À clarifier côté gouvernance : qui est autorisé à modifier une règle en urgence, dans quels cas, et comment est assurée la traçabilité. Ces points relèvent de politiques internes et, selon contexte, d’une validation sécurité/juridique spécialisée.
WAN (fibre/DSL/radio), multi-sites et lien de secours
Pour des organisations multi-sites (agences, sites industriels légers, hôtels, sièges), l’indisponibilité WAN est un risque majeur. Les mesures pertinentes sont :
- Disponibilité du lien et de la passerelle opérateur (avec prudence : un lien peut être “up” mais dégradé).
- Qualité : pertes, latence, gigue, sur des périodes cohérentes avec l’usage.
- Bascule (si LTE/4G/routeur de secours) : état, capacité réellement disponible, tests contrôlés.
- Objectifs contractuels : suivi d’indisponibilité et de temps moyen de rétablissement / résolution (selon la définition retenue dans votre organisation et vos contrats) pour alimenter les échanges avec l’opérateur et documenter les incidents.
Les modalités exactes (SLA, GTR, pénalités, tests de bascule) relèvent du contrat et de l’architecture ; elles doivent être définies et validées au cas par cas. En pratique, l’intérêt opérationnel est d’aligner vos SLO internes (objectifs de service) sur ce que vous pouvez réellement tenir compte tenu de la couverture opérateur et du modèle d’astreinte.
DNS / DHCP / AAA (si inclus dans votre périmètre)
De nombreux incidents “réseau” sont en réalité des défaillances de services d’infrastructure. Si ces services font partie de votre périmètre de supervision :
- DNS : temps de réponse, échecs, cohérence de résolution pour des noms critiques (internes et externes).
- DHCP : disponibilité, épuisement de pools, erreurs d’attribution.
- AAA (Authentication, Authorization, Accounting : ex. RADIUS/annuaire) : échecs d’authentification, indisponibilité (en distinguant panne et erreurs de configuration/identifiants).
Collecter des données fiables avec SNMP, syslog et les outils du fabricant
La supervision s’appuie sur plusieurs sources complémentaires. Les sondes ICMP renseignent sur la joignabilité d’un équipement, sans prouver que les applications fonctionnent. SNMP permet de relever des interfaces réseau, leurs états et leurs compteurs, si le constructeur les expose. Les journaux syslog apportent un contexte d’événements, tandis que les API ou outils de gestion des fabricants peuvent fournir des informations propres aux points d’accès, contrôleurs, pare-feu ou alimentations.
Pour SNMP, on privilégie généralement SNMPv3 avec authentification et confidentialité (authPriv) lorsque les appareils le prennent en charge, car SNMPv3 définit notamment un modèle de sécurité (USM) dédié (source : RFC 3414 — SNMPv3 USM). Le choix des suites (algorithmes, niveaux) dépend toutefois des capacités des équipements et de la politique SSI : la RFC 3414 reflète une spécification historique, et des extensions (ex. SHA‑2) existent (source : RFC 7860 — SNMPv3 USM SHA‑2).
Lorsque SNMPv3 n’est pas disponible partout, l’objectif de projet à tenir est de réduire le risque d’exposition : segmentation/isolement du réseau de management, filtrage strict des flux, limitation des droits (lecture seule lorsque possible) et comptes dédiés à la supervision. À l’inverse, laisser SNMPv1/v2c accessible depuis un réseau étendu ou partagé augmente la surface d’attaque : le niveau d’acceptation de ce risque doit être arbitré en fonction du contexte.
Syslog est souvent indispensable pour comprendre une bascule de lien, une boucle, ou une instabilité. Selon les équipements et l’architecture retenue, le transport et l’accès aux journaux peuvent être durcis au cas par cas, par exemple via un réseau d’administration isolé, un tunnel chiffré (VPN) vers le collecteur, ou une capacité de transport chiffré fournie par certains équipements. Il n’existe pas une méthode universelle applicable à tous les environnements : ce point doit être cadré en conception (périmètre, contraintes des équipements, exploitation).
Pour un ancrage Maroc côté gouvernance, la Directive Nationale de la Sécurité des Systèmes d’Information (DNSSI) (DGSSI) traite notamment de la journalisation/traçabilité et de la synchronisation temporelle. Elle mentionne aussi, pour certains types de traces et selon les contextes, des durées minimales de conservation (repères à interpréter selon le périmètre et le statut de l’entité) (source : DNSSI — DGSSI, sections relatives à la traçabilité/journalisation et à la synchronisation).
Enfin, la supervision ne doit pas devenir elle-même un point de compromission. Un serveur ayant accès à de nombreux switches et pare-feu doit être administré, sauvegardé et surveillé. La publication NIST SP 800-137 (ISCM) apporte un cadre de gouvernance pour la surveillance continue ; elle ne définit pas des seuils matériels universels à appliquer à un réseau hôtelier ou d’entreprise.
Pour approfondir la segmentation du réseau de management, voir notre guide de cybersécurité hôtelière.
Indicateurs orientés service : SLI/SLO et tests synthétiques
Pour piloter une supervision réseau entreprise au niveau décisionnel, il est utile de compléter les métriques techniques par des indicateurs orientés service :
- SLI (Service Level Indicator) : mesure observée (ex. disponibilité d’un test HTTPS vers une application).
- SLO (Service Level Objective) : objectif interne sur la période (ex. cible mensuelle), à définir selon les enjeux et moyens.
Sans imposer de valeurs “universelles”, vous pouvez définir des tests synthétiques (illustratifs) :
- Parcours “accès Internet” : résolution DNS → ouverture TLS → requête HTTP(S) vers une cible représentative.
- Parcours “application métier” : DNS interne/privé (si applicable) → TLS → page de santé/endpoint (si l’application le permet).
- Parcours “portail captif Wi‑Fi invité” (si existant) : obtention IP (DHCP) → redirection → accès Internet.
Une bonne pratique consiste à relier chaque test à une action : “qui fait quoi” si le test échoue, et quelles vérifications sont autorisées (ex. vérifier la passerelle, le DNS, la route, ou escalader vers l’opérateur / l’intégrateur / l’éditeur).
Transformer les mesures en alertes réellement exploitables
Une alerte utile doit indiquer le service concerné, les équipements et zones affectés, les premières vérifications autorisées et le responsable à prévenir. Les seuils instantanés créent souvent trop de bruit : mieux vaut tenir compte de la durée d’une anomalie et de la criticité du service. Dans un établissement hôtelier, la perte du cœur réseau qui dessert plusieurs étages ne doit pas avoir le même niveau de priorité qu’une interface de réserve inutilisée.
Quel que soit l’outil retenu, l’objectif est de réduire les faux positifs (bruit) et de produire des alertes qui mènent à une décision : vérifier, escalader, ou observer en tendance. Concrètement, cela passe souvent par (1) des délais de déclenchement adaptés, (2) des seuils contextualisés (heures pleines/creuses), et (3) des messages d’alerte qui décrivent l’impact et la première action attendue.
À faire / À éviter (exploitation)
- À faire : définir des alertes par service (impact), avec durée et escalade (jour/nuit).
- À faire : nommer clairement les interfaces (description de ports) pour relier l’alerte au terrain.
- À éviter : transformer chaque log “warning” en incident prioritaire sans qualification.
- À éviter : dépendre d’un seul signal (ex. ping) pour conclure à la disponibilité d’un service.
Exemple de matrice de supervision d’un hôtel
| Service / équipement | Indicateurs | Exemple de déclencheur | Action / destinataire |
|---|---|---|---|
| Accès Internet de la réception | Test extérieur applicatif, résolution DNS, pertes et latence | Échec de plusieurs contrôles successifs vers des cibles représentatives | IT : vérifier opérateur, routeur, DNS et liaison de secours |
| Uplink de baie d’étage | État du port, débit, erreurs et pertes | Port actif devenu indisponible ou hausse anormale des erreurs | Mainteneur réseau : contrôler fibre, optiques, brassage et alimentation |
| Points d’accès Wi-Fi | Connexion au contrôleur, capacité clients, erreurs, qualité radio si disponible | Plusieurs AP d’une même zone injoignables ou service invité dégradé | IT : distinguer incident radio et panne de switch ou d’uplink |
| Switch alimentant caméras et AP | Puissance PoE consommée, refus d’alimentation, température, ventilateurs | Refus PoE ou alerte matérielle remontée par le constructeur | Maintenance : comparer budget réel, santé de la baie et équipement |
| Serveur de supervision | Capacité de collecte, dernier relevé reçu, délai d’acheminement des notifications | Absence de collecte ou échec d’une notification de test | Administrateur : rétablir la supervision elle-même |
Les seuils et délais de la matrice sont illustratifs : ils doivent être configurés avec les équipes d’exploitation en fonction des services, des périodes d’occupation et de la capacité réelle du site. Un taux d’utilisation de 80 % n’est pas, en soi, une panne ; une liaison peut être saturée à un moment précis sans problème utilisateur, ou présenter des pertes de paquets à faible utilisation.
Corréler les dépendances et éviter les cascades d’alertes
Si un switch d’étage perd son alimentation, les points d’accès, caméras et téléphones qui en dépendent peuvent devenir simultanément injoignables. La plateforme doit conserver les événements techniques, mais présenter une cause potentielle commune plutôt qu’ouvrir une quarantaine d’incidents urgents indépendants.
Point d’attention : cette « cause probable » n’est pas automatique. Elle suppose une modélisation des dépendances (topologie, liaisons, liens physiques/logiques) et/ou des règles de corrélation propres à l’outil retenu. Sans ce travail, vous aurez mécaniquement des cascades d’alertes.
La supervision doit aussi mesurer sa propre disponibilité : une collecte silencieusement interrompue n’est pas une preuve de bon fonctionnement du réseau. Il convient d’utiliser des contrôles externes ou des tests réguliers de la chaîne collecte → alerte → notification lorsque l’architecture le permet.
Encadré décisionnel (Maroc) : gouvernance, SLA et modèle d’exploitation
Selon la maturité interne et la dispersion géographique, la supervision réseau peut être opérée en interne, par un prestataire, ou en mode hybride. Avant d’outiller davantage, clarifiez :
- Couverture horaire : qui traite les alertes le soir/week-end, et pour quels services seulement (ex. Wi‑Fi invité vs applications de paiement / téléphonie) ?
- Multi-sites : comment prioriser une agence “down” vs un siège dégradé, et qui a accès au matériel sur place (réception, maintenance, sous-traitant) ?
- Dépendance opérateur : quels engagements tels que stipulés au contrat (SLA/GTR) existent, comment collecter des éléments factuels d’incident (horodatage, durée, impact), et quel circuit d’escalade est réaliste.
- Compétences : quelles actions peuvent être menées localement (brassage, redémarrage, remplacement) vs à distance (diagnostic, configuration), et par qui (IT interne, intégrateur, infogérant).
- KPI de pilotage (exemples) : disponibilité par service, temps moyen de rétablissement/résolution (définition à convenir), nombre d’alertes critiques/mois, taux de faux positifs, temps moyen de qualification.
Ces choix influencent directement le niveau d’alerting “acceptable” : une alerte sans action possible doit être traitée comme un signal de monitoring (tendance), pas comme une urgence.
Exemple pratique : réagir à la perte d’un étage
Imaginons qu’à 20 h 30 la réception signale une panne du Wi-Fi sur un étage et que le système relève simultanément la disparition de plusieurs AP. Le superviseur doit d’abord permettre d’identifier le switch d’accès commun, vérifier son uplink et son alimentation, puis déterminer si la téléphonie ou les équipements techniques desservis sont également affectés.
La procédure d’intervention ne se limite pas à « redémarrer le switch ». Elle précise qui vérifie l’état de l’onduleur (UPS, Uninterruptible Power Supply / onduleur), qui est autorisé à manipuler le matériel, quelles conséquences le redémarrage entraînerait sur les autres services et qui doit informer la réception. Après correction, un test d’utilisation du réseau depuis la zone concernée confirme la restauration ; le simple retour d’un voyant vert est insuffisant.
Un rapport d’incident bref doit conserver l’heure de détection, les services affectés, les vérifications, la cause confirmée lorsqu’elle est connue et les actions préventives décidées. Ces informations alimentent ensuite la revue des seuils et les décisions d’investissement.
Conserver des tendances pour mieux investir
Le suivi historique permet de repérer les saturations récurrentes, les équipements en fin de capacité et les zones dont la radio se dégrade. Les décisions de remplacement d’un switch, d’ajout d’un point d’accès ou de hausse de capacité WAN devraient être fondées sur plusieurs observations.
Les données doivent rester proportionnées au besoin. Conserver indéfiniment tous les journaux détaillés crée des coûts et des risques inutiles. Formalisez des périodes de conservation et des contrôles d’accès adaptés. Si certaines traces contiennent des données permettant d’identifier directement ou indirectement une personne, le cadrage doit aussi intégrer les principes de finalité et de durée nécessaire (source : Loi 09‑08 (CNDP) — principes généraux).
Recetter aussi le système de supervision
Coupez volontairement un lien non critique, simulez une panne de service et vérifiez la chaîne complète : collecte, détection, qualification, notification, escalade et retour à l’état normal. Contrôlez que l’outil n’envoie pas d’alerte faussement rassurante lorsque sa propre collecte échoue.
Scénarios de recette (illustratifs) :
- Perte d’uplink d’étage : l’alerte doit remonter “cause potentielle”, pas 20 incidents AP.
- Épuisement du budget PoE : détection avant les refus d’alimentation (si l’équipement expose la donnée).
- DNS défaillant : le test synthétique “DNS + HTTPS” doit échouer même si le ping du routeur répond.
- Test notification : envoi planifié pour valider la chaîne collecte → alerte → destinataires.
Ce contrôle rejoint les principes du cloisonnement des réseaux et de la documentation des accès techniques : une supervision performante dépend d’une architecture réseau claire.
Quels indicateurs mesurer en priorité ?
Les compteurs normalisés des interfaces fournissent un point de départ : état opérationnel, octets reçus et transmis, erreurs et paquets écartés. Une augmentation d’erreurs et une hausse des paquets écartés ne décrivent pas la même cause ; elles demandent des diagnostics différents.
Les équipements administrativement désactivés ne doivent pas déclencher automatiquement des incidents. Il faut également tenir compte des changements d’index, des réinitialisations de compteurs et des ports inactifs volontairement exclus du périmètre. Le superviseur gagne à identifier chaque port par une description lisible plutôt que par un numéro découvert sans contexte.
| Famille | Mesures utiles | Questions à se poser |
|---|---|---|
| Disponibilité et dépendances | État du switch, uplinks, contrôleur, services applicatifs | La panne touche-t-elle un équipement, un lien ou plusieurs services dépendants ? |
| Qualité de transport | Débit entrant/sortant, erreurs, discards, pertes, latence, gigue selon service | Y a-t-il saturation durable, défaut physique ou dégradation applicative ? |
| Wi-Fi professionnel | AP actifs, état contrôleur, clients par zone, alarmes radio pertinentes | Le problème est-il radio, réseau filaire, authentification ou accès Internet ? |
| PoE et énergie | Puissance disponible/consommée, ports refusés, alimentations et UPS | Les charges critiques disposent-elles toujours de la puissance requise ? |
| Santé matérielle | Température, ventilateurs, optiques, erreurs matérielles remontées | Le matériel approche-t-il une limite nécessitant une intervention ? |
| Sécurité / administration | Changements de configuration, tentatives de connexion, disponibilité de collecte | Le signal est-il une action attendue ou une anomalie à qualifier ? |
Une supervision utile privilégie les mesures qui conduisent à une action, et non l’accumulation de compteurs. Les indicateurs réellement disponibles dépendront du fabricant, du modèle, des licences éventuelles et des autorisations du collecteur.
Checklist opérationnelle
- Dresser la liste des services métiers et des équipements qui les supportent.
- Identifier les alertes réellement actionnables.
- Fixer des seuils adaptés aux heures d’usage et à l’historique.
- Ajouter, si possible, des tests synthétiques orientés service (DNS + TLS + requête).
- Sécuriser comptes, flux SNMP et collecte de journaux (selon capacités et architecture retenue).
- Prévoir escalade jour/nuit et responsables nommés.
- Tester une panne réelle ou simulée et mesurer le délai de réaction.
- Réviser périodiquement les seuils et les procédures.
Questions fréquentes
La supervision exige-t-elle un logiciel particulier ?
Non. Plusieurs solutions sont possibles. La priorité est la compatibilité de collecte, la sécurité, la capacité de corrélation et une escalade réellement exploitable.
Faut-il surveiller chaque port ?
Les ports utiles méritent une visibilité adaptée ; l’alerte doit toutefois se concentrer sur ceux dont l’incident a un impact métier. Le reste peut être conservé en historique (tendance) sans déclencher d’incident.
La supervision remplace-t-elle la maintenance ?
Non. Elle aide à détecter, qualifier et suivre les incidents ; le diagnostic et l’intervention restent nécessaires.
Références techniques pour approfondir
- RFC 3414 — SNMPv3 USM : modèle de sécurité et principes d’authentification/confidentialité.
- RFC 7860 — SNMPv3 USM SHA‑2 : extension d’authentification SHA‑2 pour SNMPv3.
- NIST SP 800-137 : cadre de gouvernance ISCM (surveillance continue) au niveau programme.
- DGSSI (Maroc) — DNSSI : repères de journalisation/traçabilité, synchronisation et conservation selon périmètre.
Conclusion : une supervision orientée services
Un tableau de bord ne remplace ni la maintenance ni les procédures d’exploitation. En revanche, une supervision centrée sur les services permet de distinguer une panne d’uplink d’un défaut applicatif, de prioriser les incidents selon leur impact et de conserver les éléments nécessaires à un diagnostic documenté.
Domocasa accompagne les projets de réseaux IP, Wi-Fi et courant faible pour les entreprises et les établissements hôteliers. Selon le besoin, l’accompagnement peut couvrir le cadrage (objectifs, périmètre, livrables), l’intégration (mise en œuvre technique) et, lorsque défini au projet, des modalités de suivi opérationnel (reporting, optimisation des seuils, amélioration continue).